金融监管领域的 Harness 实践:让知识与数据驱动 Agent 稳定运行
场景特征与痛点
金融监管报送是对数据准确性要求近乎苛刻的垂直领域。所有金融机构(银行、财务公司、小贷公司)都受到强监管要求,核心动作是"报送"——将经营关键信息报送给监管机构审查。小型机构中报送约占三分之一工作量,大型机构也占五分之一。今年上半年行业罚款已达数亿级别。
场景四大特点:
- 口径复杂:同一贷款信息在信贷、财务、统计部门结果可能不同,且口径在组织内部被各自理解,缺乏统一标准
- 频度高:按月、按旬、按周各种节奏,处理繁复
- 零容错:97% 准确率远远不够,要求 100%,原则是"宁可不报,不能报错"
- 强追溯:数据出来后必须能完整追溯定位到出问题的环节
三大痛点根源都在 Agent 自由发挥:
- 口径漂移:业务口径没变但数据口径截然不同
- 幻觉:大模型根据自己理解推理出实际不存在的范围
- 不可解释:每个数、每次计算都需要合理归因
Agent 介入的四段环节与四个强制要求
Agent 在报送流程中介入四段:需求侧(监管要求理解+指标体系)、审核复核(数据加工检查、指标计算、异常提醒)、问题处置(定位修复、根因分析、血缘追溯)、报送前复核(交叉检验+复核报告)。
场景对 Agent 提出四个强制要求:口径受控(不允许发散)、数据可查强追溯(走受控通道)、逻辑可查(能力调用受控)、能力可复用(同样输入必须得到同样结果)。
核心定位不是"更聪明的 Agent",而是"受到严格约束的 Agent"。
Harness 架构:双底座 + 执行层
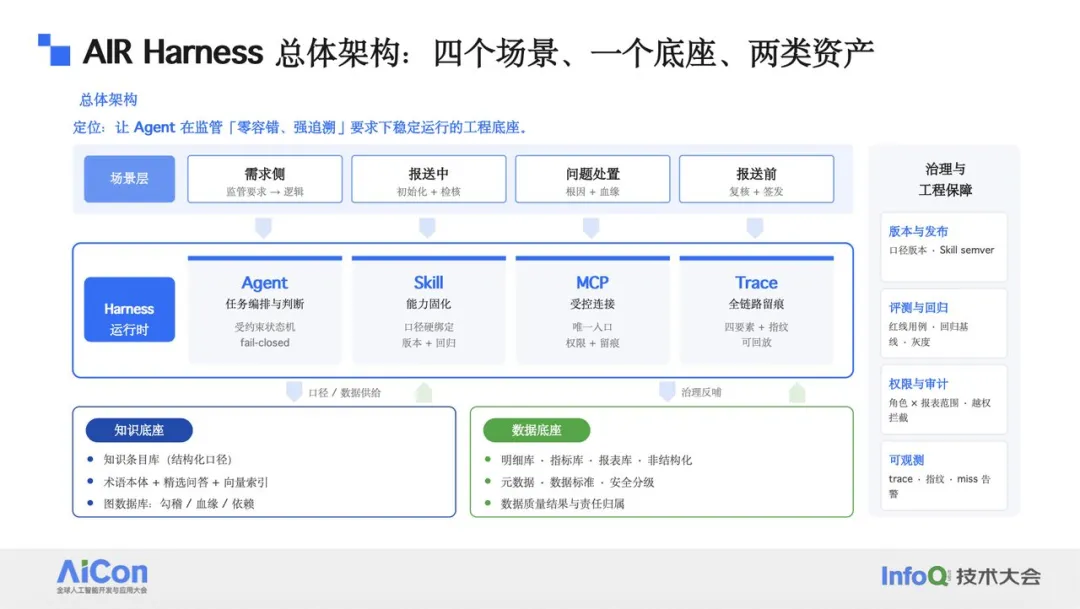
架构有两个基础:
知识底座:监管发文、制度 + 银行内部业务知识。向量+精确数据处理+图库综合运用。关键策略是知识切片——针对特定 Agent 只给相关知识切片,知识过多会造成幻觉。
数据底座:明细数据、指标数据、报表数据 + 非结构化数据。元数据、数据标准、安全分级分类构成支撑层。通过数据标准和企业用户结合,限制 Agent 只能查权限范围内的数据。
双底座之上是执行层:任务编排与判断、Skill 能力固化、MCP 受控连接、全过程可追溯。侧面是治理和工具保障。
版本管理贯穿始终——监管口径每年至少一变,变动幅度约 30%,知识版本和数据版本必须清晰管理。
从自由循环到受控状态机
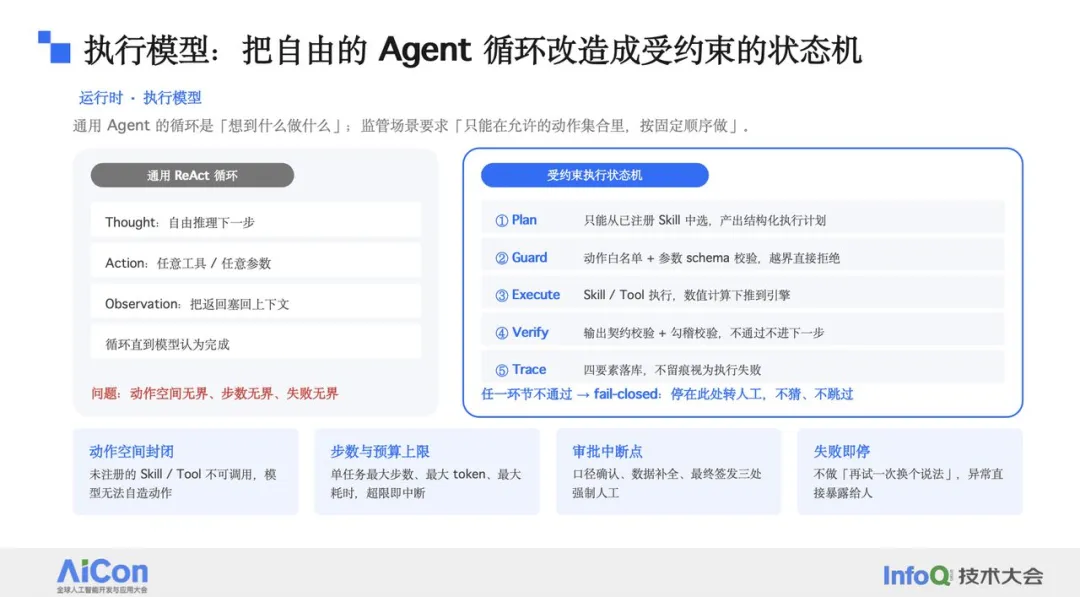
正常 Agent 循环(推理→调用工具→执行→返回结果)相对不受控。改造为受控状态机的五个方面:
- 计划环节:只能从已注册 Skill 范围内取用,产出结构化执行计划
- 保护环节:动作白名单 + Schema 校验,越界直接拒绝
- 执行环节:确定性处理过程下推到 Python/Java 程序,Agent 只调用 Tool
- 检核环节:契约检核 + 一致性校验,不通过不能走下一步
- 过程维度检查:四个维度缺任何一个即判定失败
额外约束:动作空间封闭(未注册 Skill 不可调用)、部署和预算上限(15 步任务超 30 步即停、Token 超限即停)、审批中断点(口径确认/数据补全/签发需人工介入)、失败即停。
报送场景 Agent 执行六步全流程
- 接单拆解:报送任务可能含数百个指标,按单个指标逐个拆解(500 个指标一次性丢给 Agent 大概率失败)
- MCP 获取口径:从分布的知识库获取指标/数据项精准口径
- 取数:根据口径描述生成取数逻辑,走受控通道
- 勾稽校验:数与数之间的关联检验(大小关系、差异率阈值)
- 异常处理:通过数据库+Agent+图库获取血缘处理逻辑,在链路每个节点做检核,给出处置意见(可能指向原始业务环节填错材料)
- 复核报告出具:专门的 Skill 自动生成复核报告,含异常说明和正常数据的计算链路
关键原则:Agent 只做编排和判断,不做取数和定义。数据口径定义在知识库建设时完成,运行过程中不允许发散。
Skill 规格与受控执行
Skill 定义采用严格结构化:口径引用(必填,指向知识库具体条目)、语义版本硬绑定、输入输出契约化(明确规定类型和枚举,防止模型发散)、血缘关系记录、数据计算引擎标识(Python/Java/SQL)。
口径受控执行的核心:只允许使用,不允许理解。口径沉淀在数据治理成果里,Agent 只能引用不能改写。如果根据口径取不到数据,可能是口径写错或过时——但 Agent 不能自己理解修改,必须保持在严格定义内。
对于口径缺失的情况,明确让模型回答"不知道",不能自己拼凑。第一批项目出现大量"不知道",用户觉得不合理,但经过一轮口径治理调整后逐渐减少,系统达到可控状态。
五类固化的 Skill
- 口径类:口径解释结构化、版本对比、适应性判定
- 计算类:指标计算、报表汇总、同期/同比/环比推导(按月/季/天算法不同)
- 校验类:表内表外勾稽、跨表一致性、值域非空检核(核心数据体系可用约十年)
- 追溯类:血缘路径查询、变更影响分析
- 取数回放:一期数据完成后链路回放
大模型在链路中的边界
允许做:意图识别、任务分解、槽位抽取(只抽取不分析)、Skill 路由和参数填充、异常判定和文本识别
不允许做:数据计算/汇总、口径判别表生成、弱化校验、生成引用
数据和知识的唯一接口是 MCP 方式连接。全链路留痕:执行 ID、调用 Skill、引用路径、数据来源、血缘路径、勾稽关系、耗时、结果、校验复核过程,人为操作也记入链路。
向量检索与图库协作
向量检索存在召回率不稳定问题(如小微企业贷款划型、普惠型小微企业)。解决方式是引入语义本体处理同义词/易混淆内容,版本和生效条件做前置处理,结构化数据放图库或知识库中相互协作。
检索路由:精确获取走组件检索,不能精确获取的通过图约束检验节点准确性/完整性/一致性。
知识库五个健康度指标:覆盖率(应 100%)、鲜度(引用版本最新)、冲突(不应有多激活条文)、过期项目清理、引用命中率。
上生产前三道关卡
- 红线机制:口径歧义、跨表勾稽错误、极值空值等任一出现不能上线
- 回归机制:每个 Skill 用历史报送跑五期十期测试
- 灰度双轨:并行跑三到五个月观察
根本理念:治理和智能相互为前提——用 AI 提高数据治理能力,通过数据治理提升 Agent 稳定性,两者相互协作。下一步计划是 Skill 资产化和可信度量评估。