Akka 在 65 个开源项目中测试基于规格的 AI 交付
实验概况
Akka 利用 65 个开源项目,对一种基于规格说明(spec-driven)的 AI 辅助软件移植工作流进行了测试,评估维度包括:规格说明的结构、上下文、模型与工作量选择、自动化验证、token 消耗以及运行时性能。
首轮测试规模:耗时 99.3 小时,消耗 94.1 亿个 token。65 个移植项目中,57 个在代码行数或性能方面实现了提升。
两阶段实验设计
- 第一阶段:对全部 65 个项目进行分析,生成规格说明,并实现每个项目最多 10% 的功能
- 第二阶段:根据系统特性和可量化结果,选出 10 个项目进行完整实现
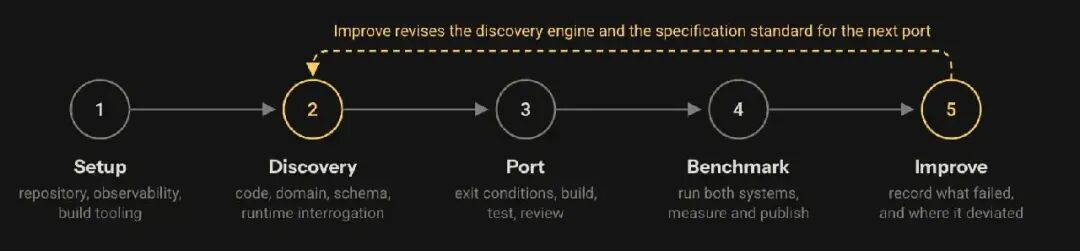
交付管控工作流(delivery control workflow)循环经历:需求发现 → 规格定义 → 移植 → 基准测试 → 优化。其中需求发现阶段分析代码、模型、模式和运行时行为;Claude 配合 Akka Specify 负责实现、测试和审查;最后通过通用基准测试运行器对比测试、代码规模和延迟。
关键发现
结构化规格说明有效,但上下文有缺口
包含声明、证据和类型化行为的结构化规格说明能够改善首次实现的效果;但上下文文件中缺少跨组件决策的内容。后续研究方向包括:接口枚举、测试数据导入、溯源追踪、差异测试和对抗性测试。
对照来看,GitHub Spec Kit 同样围绕规格说明、规划、任务、实现和收敛这几个环节对编码代理的工作流做了结构化设计——思路趋同。
模型选择:便宜模型反而更"守规矩"
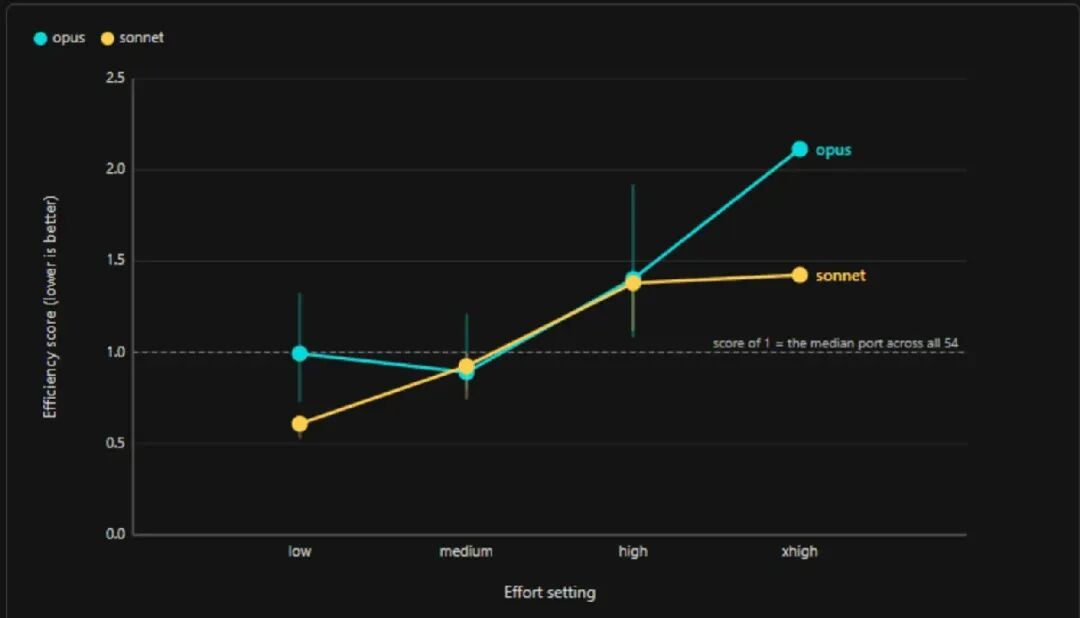
- Sonnet:平均每项移植耗时 61 分钟
- Opus:平均每项移植耗时 120 分钟,但 token 消耗量少约 40%
提高工作量(effort)设置会增加消耗,却并不能获得持续的效率提升。
LinkedIn 上工程师 Aaditya 在 Akka CEO Tyler Jewell 的博文下评论:规模较小的模型行为与他观察到的现代化改造工作相符——较小的模型会严格遵循规范,而较大的模型可能会进行即兴调整。他还提出一个尖锐问题:代码行数的减少主要源于死代码移除,还是源于目标语言的差异?
Avahi 市场部负责人 Rick Bryce 则指出限制条件可能会影响结果。这些讨论引出一个开放问题:移植效率的差异究竟源于模型能力、规格限制,还是两者兼有。成本更低的模型能实现更精确的移植——这个发现值得深入探究。
验证与性能
验证采用原始的单元测试和集成测试,同时由审核人员检查序列化、安全性、错误处理、PII、幂等性以及架构边界。随着移植故障暴露新问题,Akka 增加了防护措施,但也指出额外的退出条件增加了移植成本。
性能表现因项目类型而异:
- 应用程序、框架和库:性能普遍提升
- 基础设施和工具:性能中位数有所下降
- 极端案例:Dify 性能提升 143333 倍(但对比的工作负载存在差异);Netflix Metaflow 运行速度反而慢了约 100 倍
Zero 的看法
这是目前少有的、样本量足够大的 AI 代码迁移实测报告,几个数据点值得记住:
- 99.3 小时 / 94.1 亿 token 迁移 65 个项目——平均每个项目约 1.5 小时、1.4 亿 token。按 Sonnet 定价粗算,单项目迁移成本在数百美元量级,远低于人工,但绝不是"接近免费"。
- 小模型更守规矩这个观察对工程落地很有价值:规格驱动的场景里,"创造性"是缺陷而非优点。选模型时benchmark 分数不如"遵循度"重要。
- effort 档位不是越高越好——这与很多人"拉满 thinking budget 求稳"的直觉相悖,值得在自己的 agent pipeline 里实测验证。
- 报告由 Akka 自己发布,本质是自家 Akka Specify 产品的营销材料,57/65 的成功率缺乏第三方复现。Dify 那个 143333 倍的数字自己也承认工作负载不可比,看看就好。
- 对前端团队的启示:如果要做大规模框架升级/迁移(如 React 18→19、Webpack→Rspack),先花精力写结构化规格说明(声明+证据+类型化行为),比直接让 agent "看着办"成功率高得多。
原文链接:https://www.infoq.com/news/2026/10/ai-spec-driven-delivery/