AI 智能体三周重构 30 万行代码,Code Health 从 5.6 升至 10.0:代码真的变好了吗?
一句话
AI 能重构 30 万行代码的前提,不是模型够强,而是你有一个它能优化的确定性指标,和一个能逐帧判定"行为没变"的验证框架。
核心论点
事实面:CodeScene 发布的案例研究中,编码智能体在三周内重构了《街头霸王 III:三度冲击》开源反编译项目的 30 万行 C 代码——726 个文件、2903 次提交、改动 252,055 行,token 成本约 4000 美元,Code Health 评分从 5.6 升至 10.0。CodeScene 创始人、《Your Code as a Crime Scene》作者 Adam Tornhill 称,这是他从业 30 年首次看到"大规模超人类 AI 表现"。
支撑这项工作的两个机制比结果本身更值得关注:
- 质量信号:CodeHealth MCP Server 为智能体提供确定性的、可优化的评分,用于判断一次转换是否产生了积极效果。
- 正确性保障:回放轨迹测试框架逐帧比较回滚状态哈希,在每次更改后检查系统行为。
更有新意的是智能体的工作方式:没有套用固定重构目录,而是逐步积累了一套重构手册——最终 22 个方案、82 条辅助说明。除 Extract Function、Guard Clauses 等常见转换外,还产出了代码库特定方案:Shared Index Range(处理仅起止范围不同的重复循环)、Action Parameter(处理主要区别在所调用函数的重复控制结构)、Uniform Step Table(异构调用转为表驱动分派)。失败的尝试(导致评分下降的转换)也被记录在案。
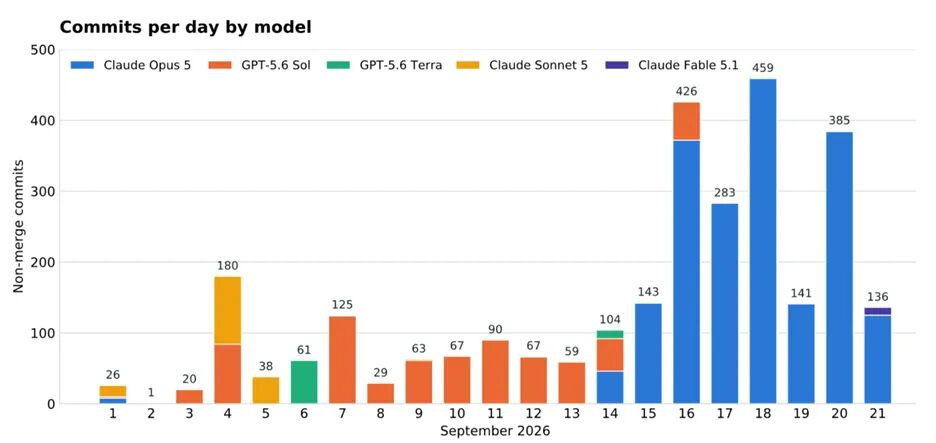
模型选择上,团队最终用 Claude Opus 完成大部分工作,并称搭配 Opus 的 Claude Code 在识别和记录渐进模式方面明显优于搭配 Sol 的 Codex。较小模型执行时,文件评分经常停滞在无法突破的局部最优。
争议面(LinkedIn 上的分歧)
争议不在"这件事是否发生",而在"它证明了什么":
- 支持方:Paolo Perrone 指出,多数重构成果建立在"测试套件全部通过"上,但那只能说明测试没失败;对格斗游戏做轨迹回放设定了高得多的标准。Omda Response CTO Mats Iremark 称自己做过类似事情,CodeScene MCP 与智能体的组合"几乎像作弊一样"。
- 质疑适用范围:Konrad Otrębski 追问这些更改是否已合并、是一次巨型合并还是多次合并、是否只是开源实验而非生产代码。参与者 Daniel Webb 回应:通过 54 个 PR 合并到了分支版本的 main。Otrębski 随后提出更高标准——"对 AI 能力真正的检验,是把这种重构服务提供给知名开源项目如 Grafana,且'完成'的定义是合并到 master"。
- 质疑措辞:Tracy Bannon 反对把结果描述为"完美"。
- 质疑方案本身:Denis Baltor 指出 DRY 关注的是知识和意图的重复而非完全相同的代码行,把"仅范围不同的循环"视为重复可能混淆二者。
- 质疑方法论:Asko Nõmm 指出 Claude Code 和 Codex 各自针对自家模型调优,无法判断结果衡量的是模型还是测试框架;且架构未被衡量——代码看起来健康,根本性问题可能日后才暴露。
- 未解答的问题:非功能行为(帧率、内存、输入延迟)是否改善?Webb 表示正引入性能专家。测试框架能否捕获细微的帧时序回归?"可能没有明确答案"——框架作为提交前钩子运行,有些故障在被观察到之前就修复了。
文章结尾的关键坦白:回放轨迹框架之所以有效,是因为反编译游戏能提供确定性的逐帧回放;多数遗留系统不存在与之相当的判定机制,而这正是重构它们有风险的原因。 Tornhill 写道,自动化测试和等价性检查是绝对必要的保障——这恰好把负担落在了不健康代码库往往最缺少的东西上。
补充两个细节:团队曾考虑用一个 Gov.UK 海事许可代码库,但它"过于健康"不适合研究;所谓"缺陷减少 70%、token 浪费减少 45%"是根据早期研究推算的,并非本次实测——4000 美元成本和三周用时才是实测值。后续 CodeScene 将与隆德大学合作,让学生用前沿模型分别在 5.6 和 10.0 两个版本中实现功能,比较成本和质量。
亮点
Otrębski 的"Grafana 标准"是全文最锋利的一句:在无人 review 的 fork 分支上合入 54 个 PR,和把重构合进 Grafana 的 master,是两种完全不同量级的"完成"。
我的判断
这个案例真正的价值不在"AI 能重构",而在它反向证明了大规模 AI 重构的准入条件:一个可优化的确定性质量指标 + 一个行为等价性判定回路。两条都满足,agent 才能从"产出 churn"变成"产出改进"。
几个需要泼冷水的点:
- 利益相关要打折:Code Health 是 CodeScene 自家指标,这是自家工具 + 自家指标 + 自家案例研究的三位一体,10.0 的含义由卖工具的人定义。它证明的是"agent 能优化一个给定指标",而古德哈特定律早就警告过指标成为目标后会失去意义。
- 可复制性门槛极高:游戏反编译天然提供逐帧确定性回放,这是绝大多数业务代码(IO 密集、非确定性、测试稀薄)不具备的 oracle。文章自己也承认了——所以这不是"AI 重构时代到来"的证据,而是"验证设施决定 AI 重构上限"的证据。
- 对团队的实际启示:想让 agent 安全地跑大规模重构,先投资可验证性——严格类型检查、快照/契约测试、确定性构建就是你的"回放框架"。没有这些设施就放 agent 跑三周,得到的只会是 2903 次提交的技术债。
- 经济账确实划算:4000 美元 + 三周 vs 人类团队做同等规模重构的报价,差两个数量级。但这个价格的前提是验证设施已经存在,而建设这些设施的成本没算进去。
一句话带走:AI 重构的瓶颈从来不在模型,在你的测试和度量基础设施——你能不能光凭自动化手段判定"行为没变"?如果不能,先别谈重构。